La réponse courte
PiPNN garantit-il une meilleure réponse de l’assistant IA ?
PiPNN prépare un index de recherche. Cela ne valide ni la date du document retrouvé ni la fidélité d’une réponse. LEDIA n’a pas testé l’algorithme.
Trois temps à distinguer dans une recherche
- 01
Organiser
Préparer la collection et ses liens : c’est l’étape étudiée ici.
- 02
Retrouver
Chercher les éléments proches de la demande.
- 03
Contrôler
Vérifier la source, sa date et la fidélité de la réponse.
Le travail invisible avant la première recherche
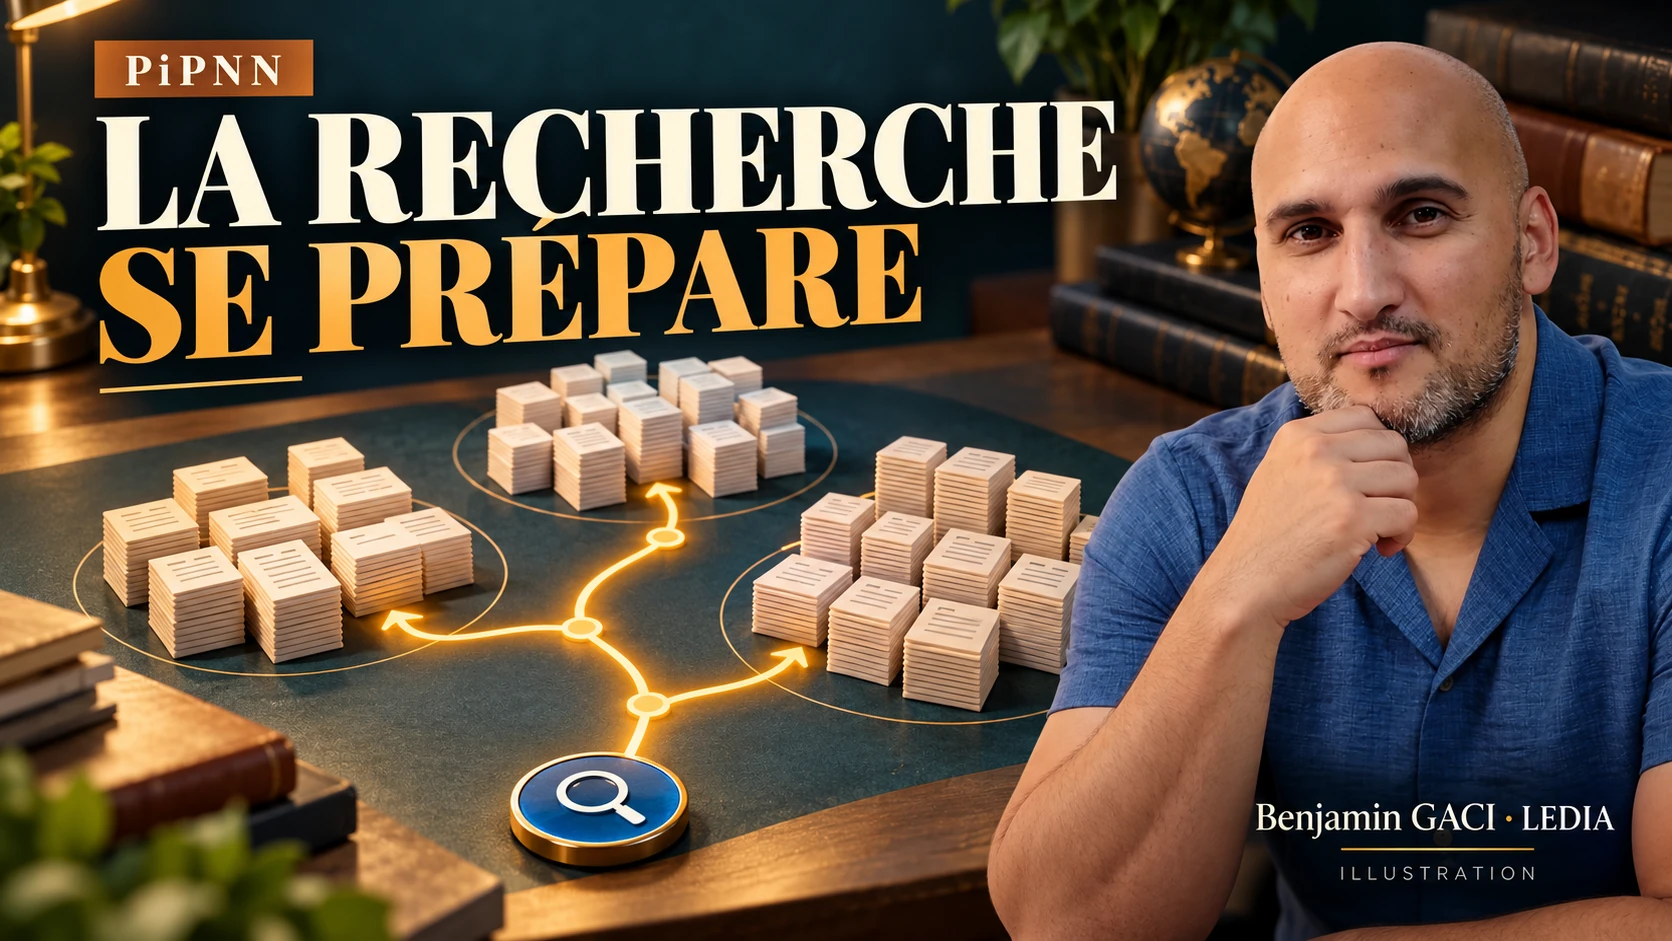
Avant votre question à un assistant, les documents peuvent déjà être organisés dans un index. Cette structure prépare des liens entre les informations afin de retrouver rapidement des éléments proches de la demande.
Le 20 octobre, l’Université du Maryland présente les travaux de son équipe et de Google Research sur PiPNN. Il ne s’agit pas d’un nouveau chatbot. Ce décryptage concerne la préparation de la recherche ; le papier est disponible sur arXiv depuis le 17 février, avec une révision du 10 juillet.
Sources : Université du Maryland / UMIACS — communiqué sur PiPNN du 20 octobre ↗ · Auteurs — PiPNN, papier et historique de publication sur arXiv ↗
Des documents voisins, sans être forcément identiques
L’université explique que des données peuvent être représentées par de longues listes de nombres. Des caractéristiques de contenu deviennent alors des positions dans un espace mathématique. La recherche dite approximative vise des éléments proches, sans garantir de retrouver tous les voisins exacts.
PiPNN prépare le réseau qui relie ces points. Il combine des groupes qui se recouvrent et un mécanisme appelé HashPrune, qui écarte certaines connexions redondantes tout en bornant la mémoire intermédiaire employée.
Sources : Université du Maryland / UMIACS — communiqué sur PiPNN du 20 octobre ↗ · Auteurs — PiPNN, papier et historique de publication sur arXiv ↗
Une seule machine, mais 2,2 To de mémoire
Les auteurs rapportent des index à l’échelle du milliard en moins de vingt minutes dans leurs expériences. Le papier précise, pour ces volumes, une machine cloud de 288 processeurs virtuels et 2,2 téraoctets de mémoire vive.
Ce matériel dépasse un ordinateur portable. Le résultat concerne la construction de l’index sur les données étudiées ; il ne chronomètre pas la réponse complète d’un assistant. LEDIA n’a pas reproduit ces mesures.
Source : Auteurs — PiPNN, papier et historique de publication sur arXiv ↗
Pourquoi préparer plus vite peut rendre une collection plus actuelle
Le communiqué souligne l’intérêt d’une construction plus rapide lorsque les données changent régulièrement. Si la préparation prend plus longtemps que l’intervalle entre deux changements, l’index peut déjà être dépassé à son arrivée.
Le code public des auteurs fournit des instructions techniques : compilation, fichiers de données et réglages. Ce dépôt s’adresse à des équipes capables d’intégrer et d’évaluer l’algorithme. Il ne constitue ni une application de recherche prête à ouvrir, ni une modification à activer dans votre abonnement ChatGPT.
Sources : Université du Maryland / UMIACS — communiqué sur PiPNN du 20 octobre ↗ · Auteurs — dépôt public ParAlg/PiPNN et instructions techniques ↗
Exemple fictif : retrouver le bon programme d’un musée
Imaginons une collection inventée de programmes d’expositions. Une fiche de 2024 et une fiche de 2026 parlent du même artiste. À la question « quels ateliers sont ouverts aux enfants cette année ? », les deux peuvent sembler proches du sujet.
Préparer rapidement un index ne décide pas quelle fiche fait autorité. Dans cet exemple pédagogique, il faudrait conserver la date de validité, retrouver le passage sur l’atelier et vérifier ses conditions. Ce scénario ne décrit aucun essai de PiPNN ni un service réellement proposé par un musée.
Une petite fiche de contrôle peut séparer trois colonnes : le passage retrouvé, la période qu’il décrit et la réponse autorisée par ce passage. Un nom d’artiste identique ne suffit pas à transférer les horaires, les âges ou les conditions d’accès d’une année à l’autre. Cette méthode de lecture reste indépendante du logiciel qui construit l’index.
Ce que cette avancée change dans la lecture d’une annonce IA
Pour comprendre une démonstration, séparez trois questions : combien de temps faut-il pour préparer la collection, pour retrouver un élément, puis pour contrôler la réponse ? Un progrès sur la première étape ne mesure pas automatiquement les deux autres.
Le réflexe utile consiste à noter le volume étudié, l’équipement employé et la tâche chronométrée. Puis à demander ce qui reste à vérifier : document actuel, passage pertinent, réponse fidèle. C’est une grille de lecture proposée ici, sans résultat d’évaluation supplémentaire. Les guides associés prolongent cette vérification des capacités annoncées et des sources.
Sources de ce décryptage
- Université du Maryland / UMIACS — communiqué sur PiPNN du 20 octobre ↗ · 20 octobre 2026
- Auteurs — PiPNN, papier et historique de publication sur arXiv ↗ · 17 février 2026
- Auteurs — dépôt public ParAlg/PiPNN et instructions techniques ↗
Synthèse originale en français, préparée avec une assistance IA à partir des sources citées. Les caractéristiques et résultats annoncés sont attribués à leurs auteurs.
Pour prolonger cette lecture
Comprendre l’étape réellement améliorée par une IA
L’étude concerne la préparation d’un index de recherche. Pour lire une annonce, identifiez la tâche mesurée avant de lui attribuer une amélioration de toute la réponse.
- Que peut faire l’IA, et que devez-vous encore vérifier ?
Distinguer une capacité démontrée dans un cadre précis de ce que l’on peut attendre dans un autre usage.
- Pourquoi l’IA se trompe-t-elle ? Le petit réflexe pour vérifier
Retrouver la source d’une réponse et examiner sa validité avant de la reprendre.
Pour préparer votre propre projet avec l’IA, découvrez les six jours de formation offerte de Benjamin GACI.
Découvrir la formation offerte →Sur inscription par email. Gratuit, sans carte bancaire.